Efectividad técnica de las tareas
Calibración de cámara y micrófono, grabación y consulta de resultados: ¿el procesamiento audiovisual en tiempo real funciona en equipos reales?
Funcionalidad · Navegabilidad
Validamos Yoodli: AI Communication Coach con nueve profesionales de 30 a 45 años. Explora la usabilidad, la experiencia de uso y las recomendaciones clave para llevar esta herramienta de inteligencia artificial a entornos laborales.
Una plataforma web de microaprendizaje que analiza en tiempo real el contacto visual, el ritmo del habla, las pausas y las muletillas, y entrega un reporte con transcripción sincronizada al video.
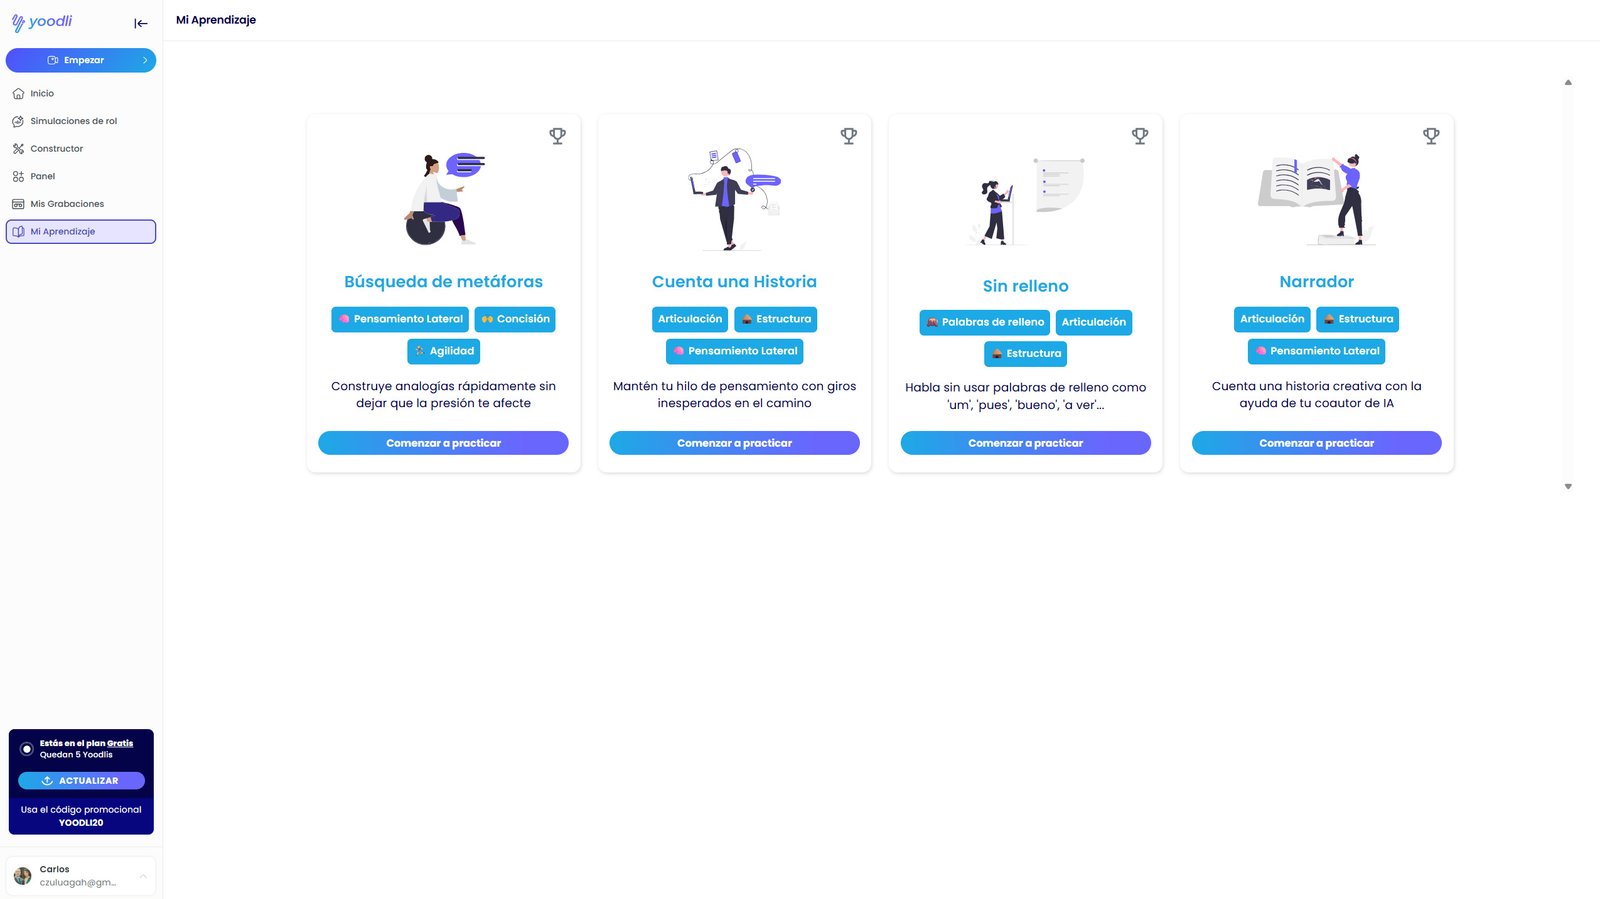
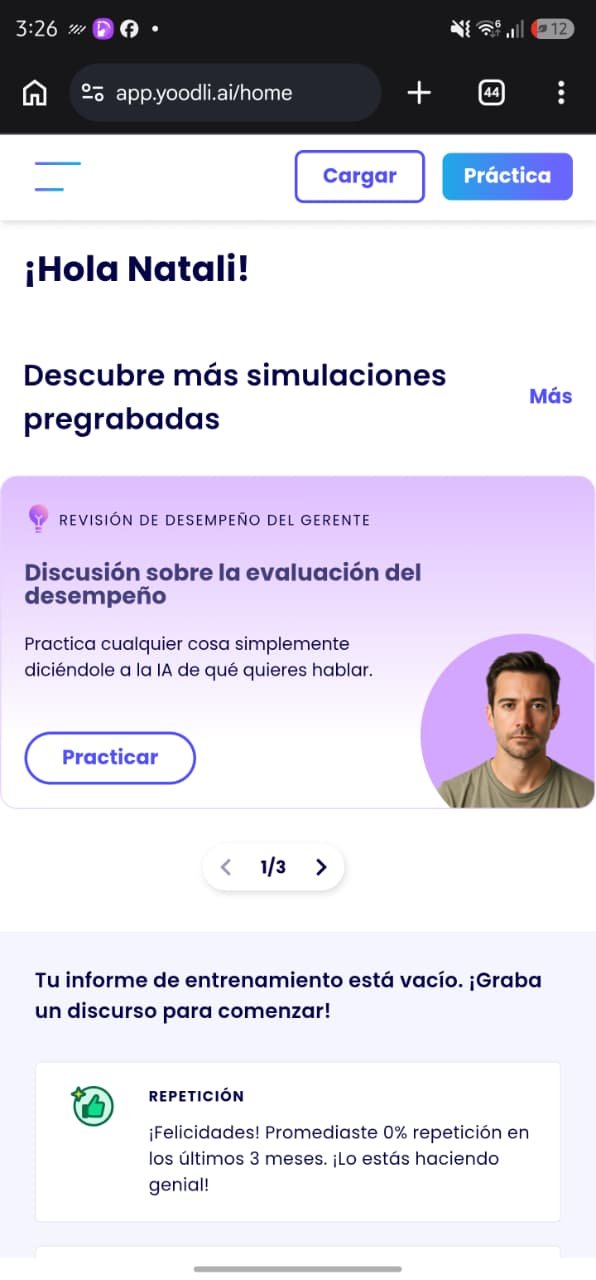
Inicio y simulaciones recomendadas
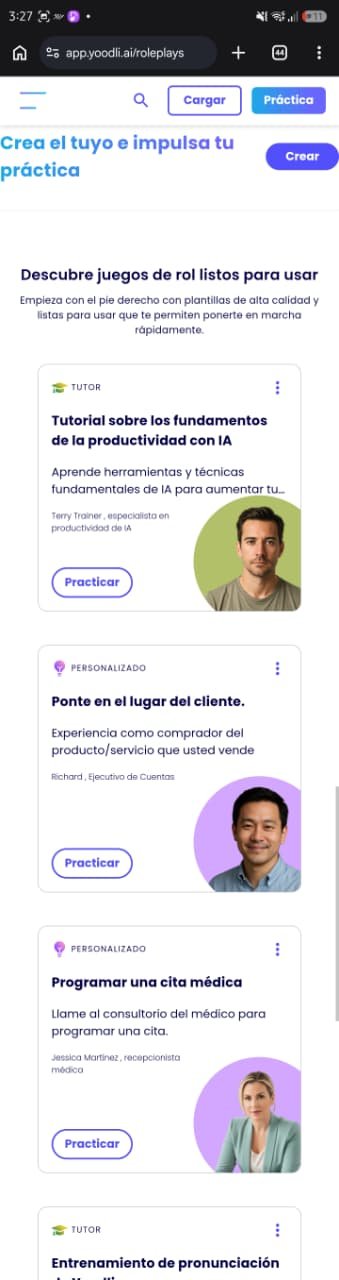
Biblioteca de juegos de roles desliza
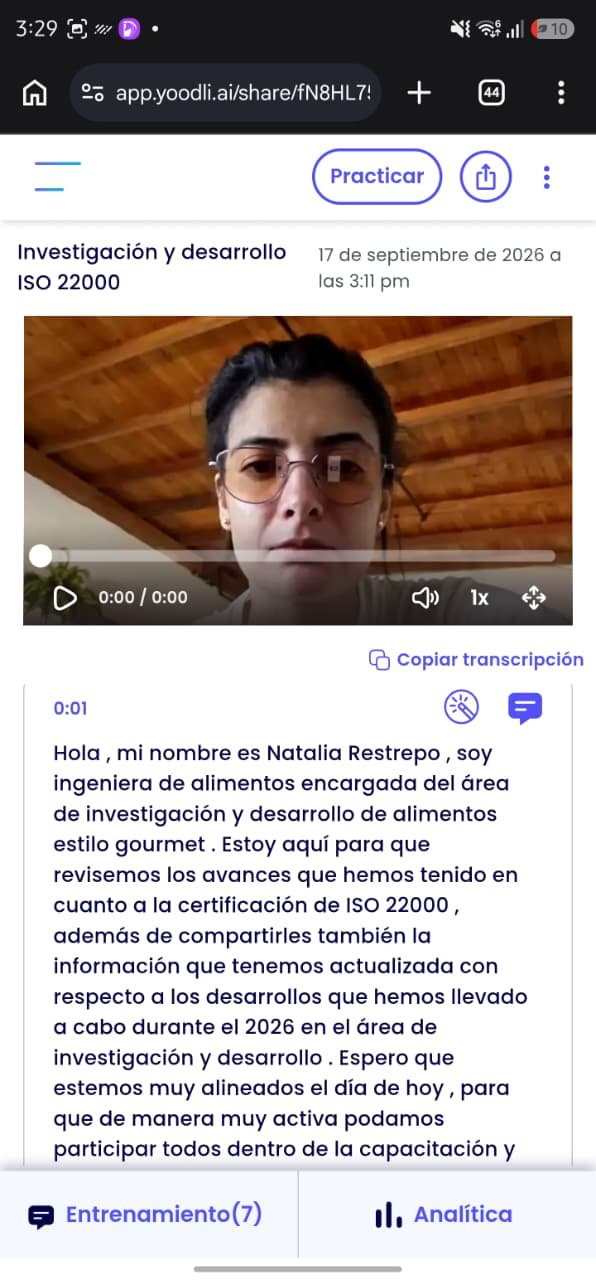
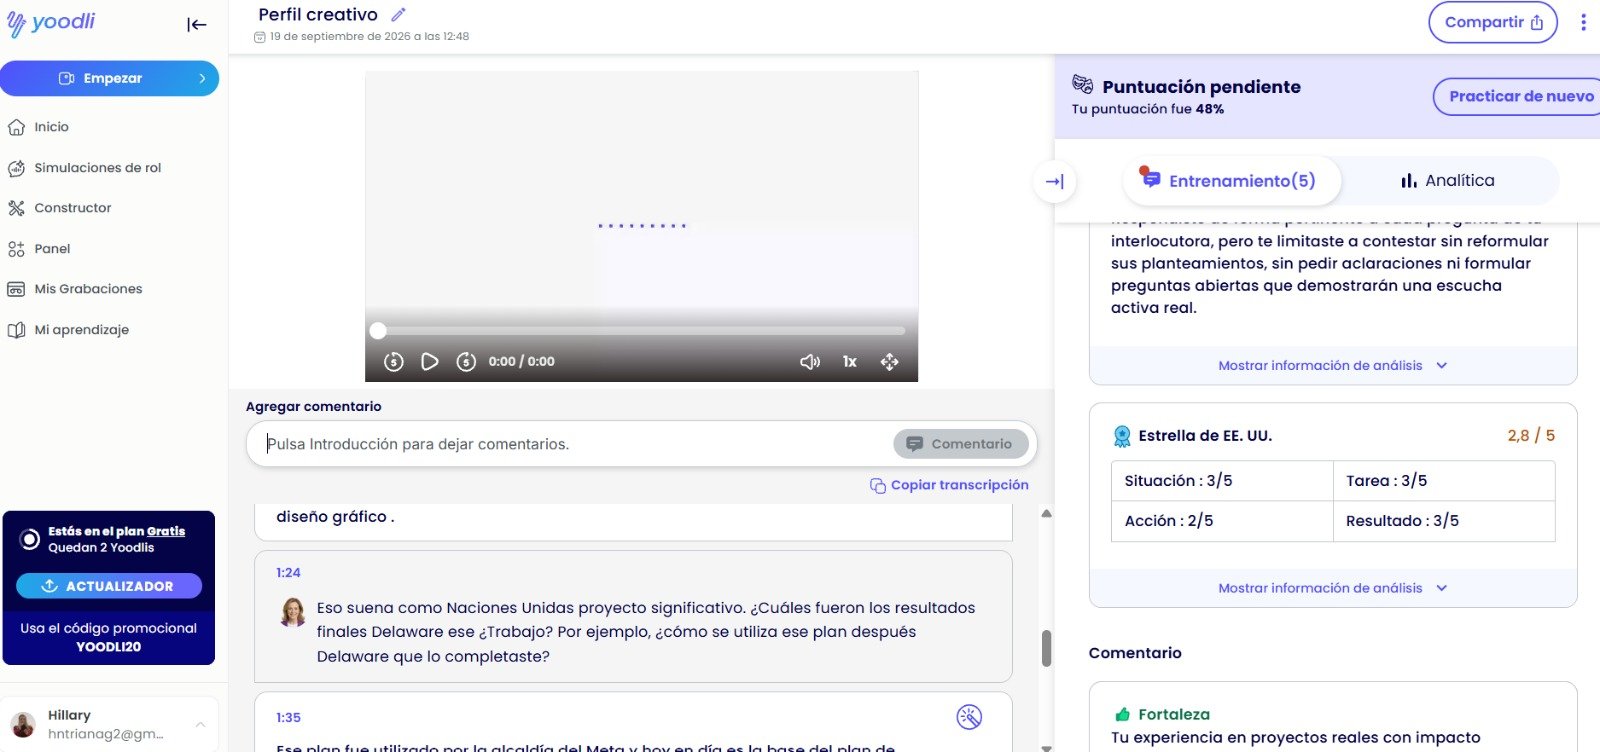
Reporte con video y transcripción
Al estar en circulación, Yoodli se evaluó tal como funciona hoy: con la latencia, los navegadores y los periféricos reales de cada participante, sin escenarios de laboratorio.
Calibración de cámara y micrófono, grabación y consulta de resultados: ¿el procesamiento audiovisual en tiempo real funciona en equipos reales?
Funcionalidad · Navegabilidad
Cuestionario de 10 ítems con respuestas de 1 a 5, aplicado tras la interacción. Se convierte en un puntaje de 0 a 100.
Brooke (1996) · Bangor et al. (2008)
Pensamiento en voz alta durante las tareas y entrevista semiestructurada de cierre sobre diseño, contenido, confianza algorítmica y privacidad.
Muñoz Jiménez (2023) · Martínez Guzmán y Chávez Maza (2016)
Autorización para el tratamiento académico de voz y datos; verificación de conectividad y periféricos.
Simulaciones de entrevistas y minijuegos de elocución, verbalizando impresiones, expectativas y dudas.
Cinco dimensiones de análisis y medición estandarizada de usabilidad al finalizar.
Género
Nivel educativo
La escala SUS convierte diez afirmaciones en un puntaje de 0 a 100. Explora los datos: pasa el cursor o toca cada barra, fila y celda.
La media muestral (n = 9) es 84,4, con desviación estándar de 11,7 e intervalo de confianza del 95 % entre 75,4 y 93,4. Cinco participantes puntuaron en rango Excelente, tres en Bueno y uno en Marginal.
Toca una barra para ver el perfil y las respuestas de cada persona.
SUS medio por segmento. La barra fina muestra el rango mínimo–máximo dentro del grupo.
La línea vertical marca la meta de 75 puntos; la línea inferior de cada barra muestra el mínimo y el máximo del grupo. Los subgrupos tienen entre 2 y 6 casos: las diferencias son descriptivas y no implican causalidad.
Mayor aprobación: el ítem 7 (colegas aprenderían rápido, 4,78/5) y el 5 (funciones bien integradas, 4,67). Mayor margen de mejora: la facilidad de uso (ítem 3, 3,67) y el deseo de uso frecuente (ítem 1, 4,11).
Detección de periféricos, precisión de la transcripción y alertas en tiempo real.
Éxito total, sin configuraciones técnicas complejas.
U2 y U3 con fallas de hardware; U4, bloqueo por permisos del navegador.
U7, U8 y U9 no las vieron; falta verificar si dependen de la versión gratuita o del ejercicio.
Fidelidad de la transcripción estimada por U1–U6: 90 % a 98 %
U7, U8 y U9 la calificaron como muy precisa, incluidas pausas, puntuación y tildes. Único error reportado: un apellido propio.
Cada celda es la respuesta bruta (1–5). El color indica cuánto aporta al puntaje: más oscuro, mejor. En los ítems marcados con (−) responder «1» es lo deseable.
Metas planteadas antes de la validación.
Media de 84,4 y ocho de nueve participantes por encima del umbral.
Solo pudo aproximarse por la activación de periféricos: micrófono 100 %, cámara 66,7 %.
La lectura de analíticas no fue cronometrada en los instrumentos aplicados.
Las entrevistas se codificaron en 62 unidades de significado según su polaridad: comentarios positivos, negativos y observaciones de mejora.
62 unidades en total. Toca un segmento para filtrar los testimonios más abajo.
Distribución por participante
Cada barra suma el 100 % de las unidades de ese grupo.
Ocho participantes coincidieron en que la retroalimentación algorítmica complementa, pero no sustituye, la empatía y el juicio de un mentor o evaluador humano. U7 no se pronunció sobre la sustitución.
Yoodli se consolida como una herramienta de alto impacto para la preparación ejecutiva. Para escalar en organizaciones hispanohablantes, estos son los ajustes que proponemos.
La práctica privada eliminó el temor al juicio; U7, U8 y U9 la describieron como cómoda y sin sensación de vigilancia.
Las muletillas y el ritmo visualizados permitieron detectar patrones inconscientes de elocución.
Ocho de nueve participantes la ven como preparación previa a la interacción con personas.
U7, U8 y U9 no percibieron las alertas: el valor provino sobre todo del reporte posterior. Es el punto de menor alineación.
En 3 de 9 participantes (33 %) la cámara no pudo activarse, lo que anuló el diagnóstico de contacto visual.
Los menús vienen en inglés; traducirlos con el navegador desconfiguró términos y generó demoras.
Los gráficos de radar muestran porcentajes absolutos, sin indicar el promedio esperado para cada rol.
No se comprobó si su ausencia obedece a la versión gratuita, a la configuración o a su baja visibilidad.
Con n = 9 (6 mujeres y 3 hombres, predominio de perfiles de comunicación y gestión) los resultados son descriptivos y no generalizables; el intervalo de confianza del SUS es amplio.
La inteligencia artificial no vino a transformar lo que decimos, sino a darnos un espejo analítico para descubrir cómo lo decimos.
Trabajo de Andrea Monsegny y Carlos Zuluaga
Módulo Análisis de audiencias digitales · Validación de un producto digital en fase de circulación